 @pan93412
Zeabur 开源了。我们把这四年开发和运维部署平台积累的经验,结合对安全性与使用体验的研究,重新实现了一个可以自托管的 Zeabur。你可以把它部署在自己的服务器或 Kubernetes 集群里,继续用熟悉的方式部署和管理服务,也可以阅读、修改它的代码。
Zeabur 2.0 的改造很早就开始了。1.0 会把每个服务的配置存在自己的数据库里,再按照它生成 Kubernetes 资源。用户需要的配置如果这套格式里没有,就得等我们先加上支持;工程师用 kubectl 直接改了集群,平台的数据又会和集群对不上。需求越多,花在这上面的时间就越多,所以我们想把这一层去掉,直接读取集群里的配置。用户提出的需求,也让我们不断回头审视原来的设计:服务数量增加以后,界面怎么帮人掌握情况?工程师需要更细的配置时,平台能不能留出足够的操作空间?出了问题,用户能不能知道该从哪里入手?
去掉这层抽象,会牵动底层架构、部署流程和界面,但现有平台上还有正在运行的服务,改造也得照顾到它们。因此,一部分工作沿着原有代码逐步改进,让用户尽量不用迁移,就能用上新功能和安全性改进;另一些影响面更广的想法,则用新的代码来做实验。一次把整个计划做完并不现实,所以我们先挑出几个过去一直没解决好的问题,一个一个重新研究。
从 Kubernetes 里找新的做法
首先,我们重新梳理了 Kubernetes 生态里现有的组件:域名、证书、存储、监控和数据库,各自都有成熟的方案。我们整理它们适用的场景,动手安装、组合,再观察哪些地方需要调整。原本需要平台自己维护的能力,有些可以直接交给现有组件;剩下的工作,就是怎么把它们串成用户容易理解的操作。
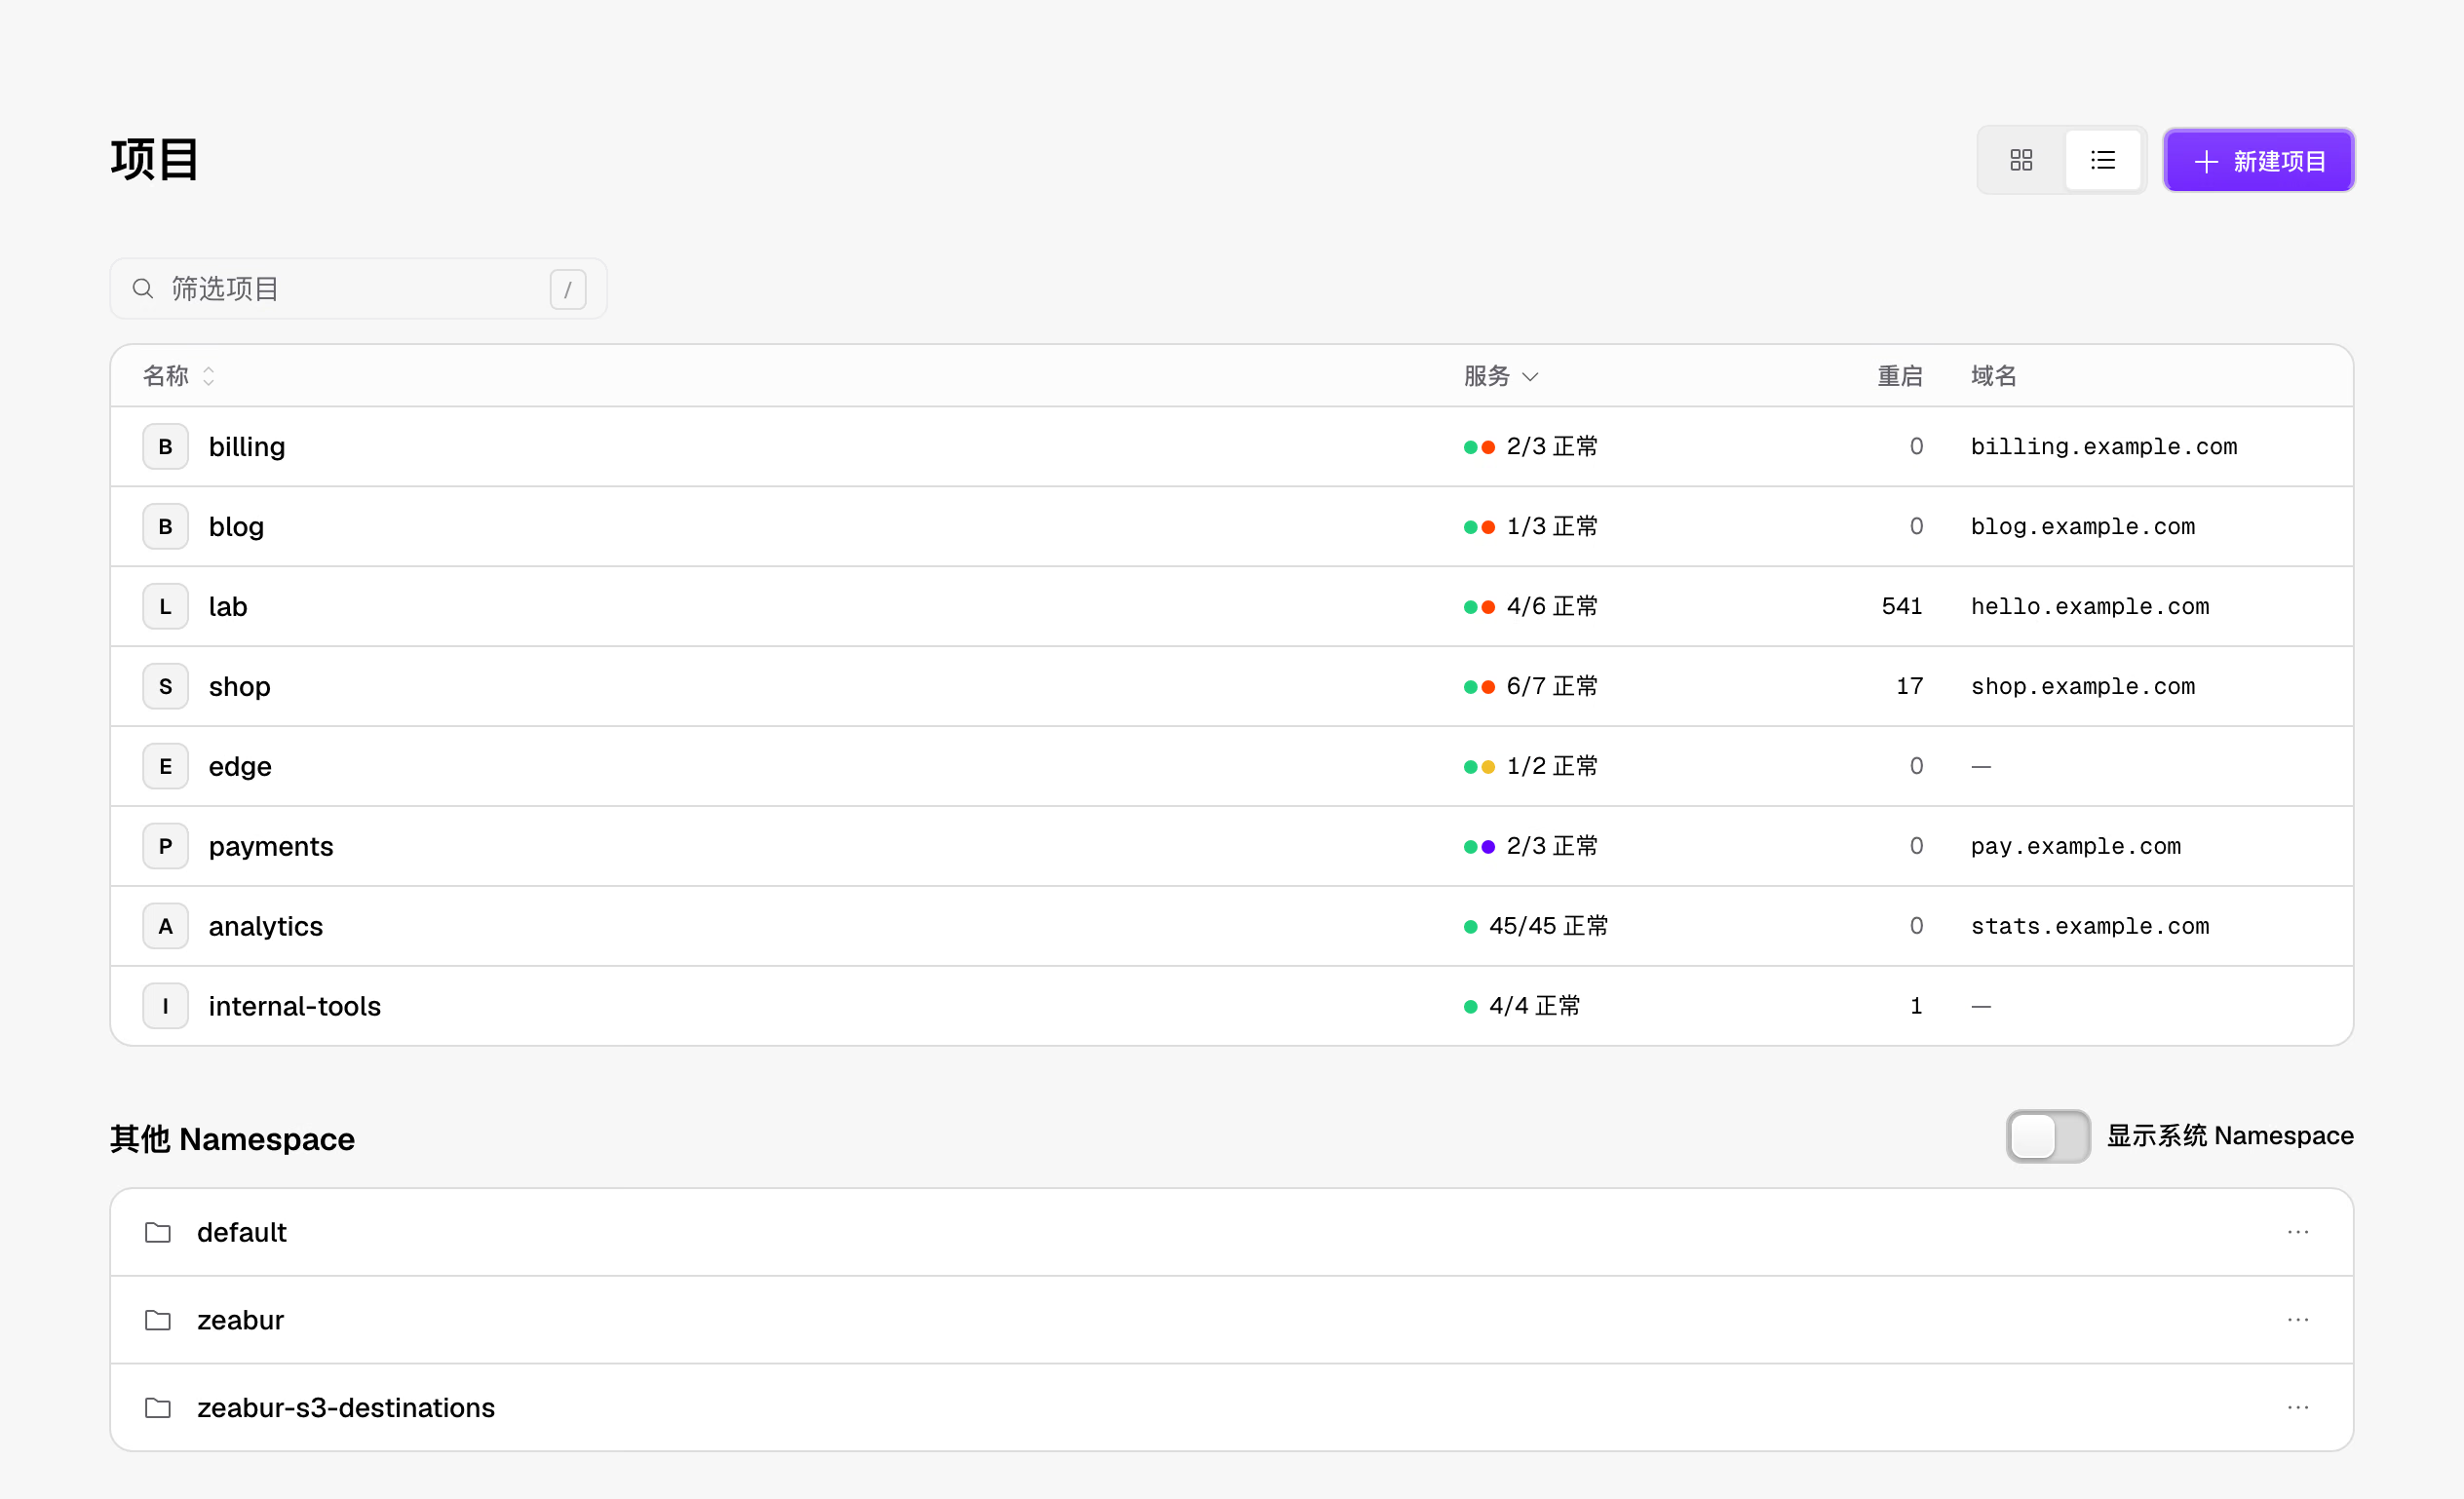
其中一个实验,就是省掉数据库里那份重复的记录,直接读取集群里正在使用的配置,从资源之间的关系找出服务、域名、环境变量和存储卷。
这些关系整理成项目视图之后,原本用其他工具部署的服务,可以直接出现在界面里;用 kubectl 改过的配置,下次读取时就能看到。用户从项目和服务开始管理环境,需要深入时,再回到原来的 Kubernetes 工具;已经有基础设施的团队,也不必为了用这个界面重新部署服务。
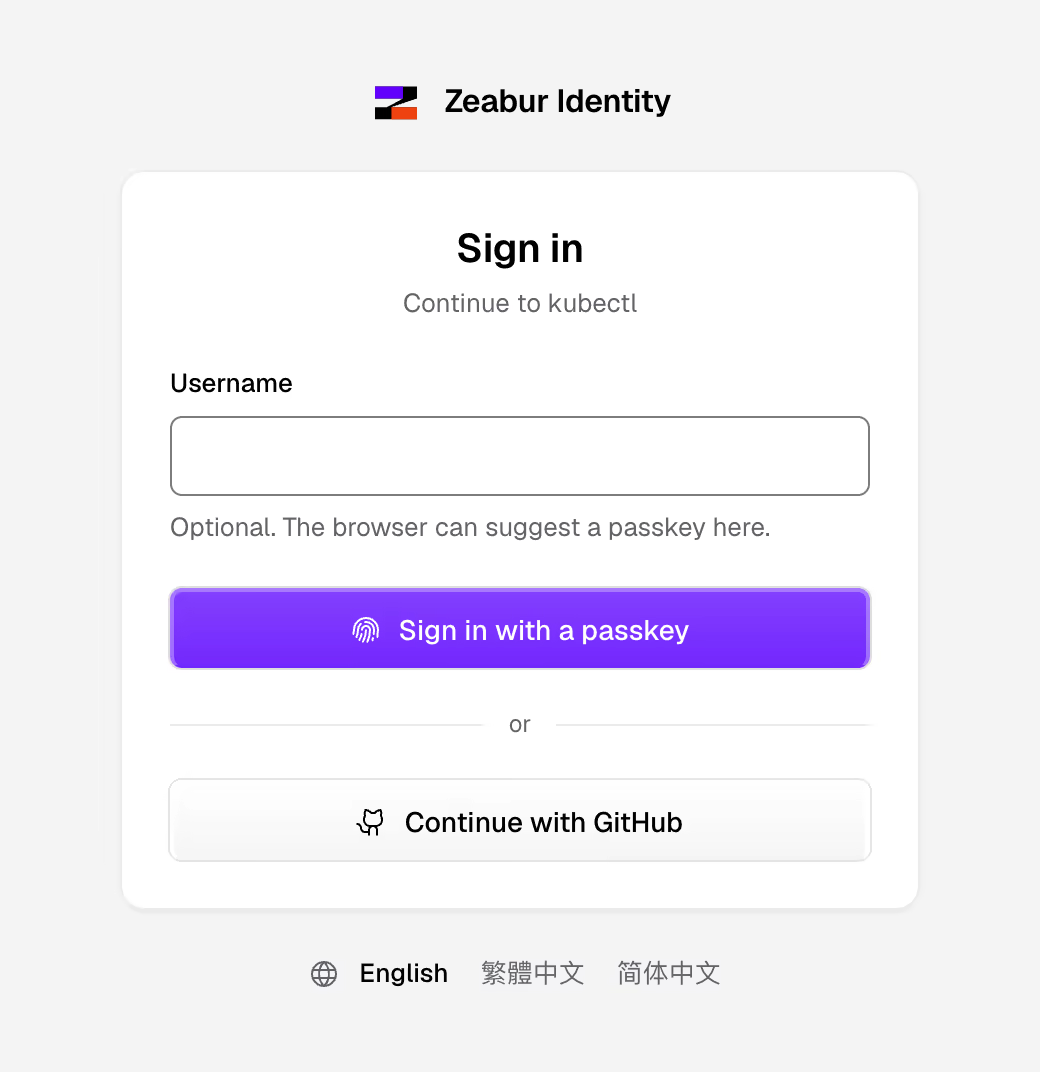
接下来是权限。用户点击“重启”或打开一份配置时,平台要以谁的身份执行?我们研究让 Kubernetes 直接验证登录者的身份,再按同一套权限规则决定能不能操作。后来登录这部分越做越完整,拆成了一个可以独立使用的项目,也就是现在的 Zeabur Identity。
把通行密钥登录、短期令牌和 Kubernetes 授权串起来,是开发过程中很让人兴奋的一步:每个人用自己的账号登录,能做什么由 Kubernetes RBAC 决定;管理员有专用账号,只能用通行密钥登录,令牌 5 分钟过期。这套流程也能接入 kubectl 和其他支持 OpenID Connect 的工具,团队成员各自登录,减少共用长期管理员凭据的情况。
在研究 2.0 的同时,原来的 Zeabur 也在持续加强安全性,比如支持通行密钥登录,以及把部分敏感数据改存到用户自己的服务器上。这也让我们在设计 2.0 时,尽量让平台少存数据、少拿权限。
后来又发生了安全事故。我们评估了现有系统需要的改造和维护之后,决定停止原有托管平台的运营。用户希望 Zeabur 能开源,我们也放不下这些已经开始出成果的研究,于是决定把它们重新整理,做成可以自托管、持续改进的开源版本。
基础打好之后,把体验做得更顺
底层问题解决之后,有些使用体验终于可以做得更好。我们把过去积累的工单和用户反馈整理成笔记,重新看用户原本想做什么、操作到哪一步开始困惑、最后又需要什么帮助。相似的困难放在一起,有些就能回到产品设计里解决。
比如,服务已经启动,网址却打不开。用户需要知道域名该指向哪里、HTTPS 是否就绪,以及应用有没有在正确的端口上响应。又比如,数据库已经创建好,下一步却要先找出账号密码,再自己拼出连接字符串,粘贴到另一个服务里。这些功能其实都在,只是过去隔着那层抽象,很难把它们串起来。所以我们开始特别留意这些地方,让一个操作能顺着接到下一个操作。
这也需要理解不同的人怎么使用平台。独立开发者可能只想尽快把程序发布上线;团队里的工程师需要部署、查日志,却没有集群管理权限;平台工程师熟悉 Kubernetes,更在意现有工具能不能继续用;有些人只需要看懂服务状态,再把问题交给负责的同事。我们整理了这些用户画像,让 Agent 按照各自的需求模拟部署、连接数据库、配置域名和排查问题,再回到界面、代码和文档,逐一检查可能卡住的地方。
早期界面就因此暴露出不少问题:它能展示 Kubernetes 资源,第一次进来的人却找不到创建项目或部署镜像的入口;构建页面写着底层组件的名称,用户真正想知道的却是“新的构建完成后,会不会直接上线”;备份配置列出完整的对象差异,却还是很难看懂备份会存到哪里、多久执行一次。后来,表单、用词和变更预览都重新调整过:常用操作先用熟悉的概念说明,底层细节放在需要时可以查看的地方。
我们也把反复用到的方法写进了开发用的 skills:写界面文案之前,先确认用户看到了什么、想完成什么;遇到权限或认证问题,先读规范和上游实现;测试时,实际检查权限不足、配置被同时修改等场景。笔记保留研究和决策的来龙去脉,skills 则让接手工作的 Agent 能沿用已经学到的方法。
把它当成每天都会用的工具
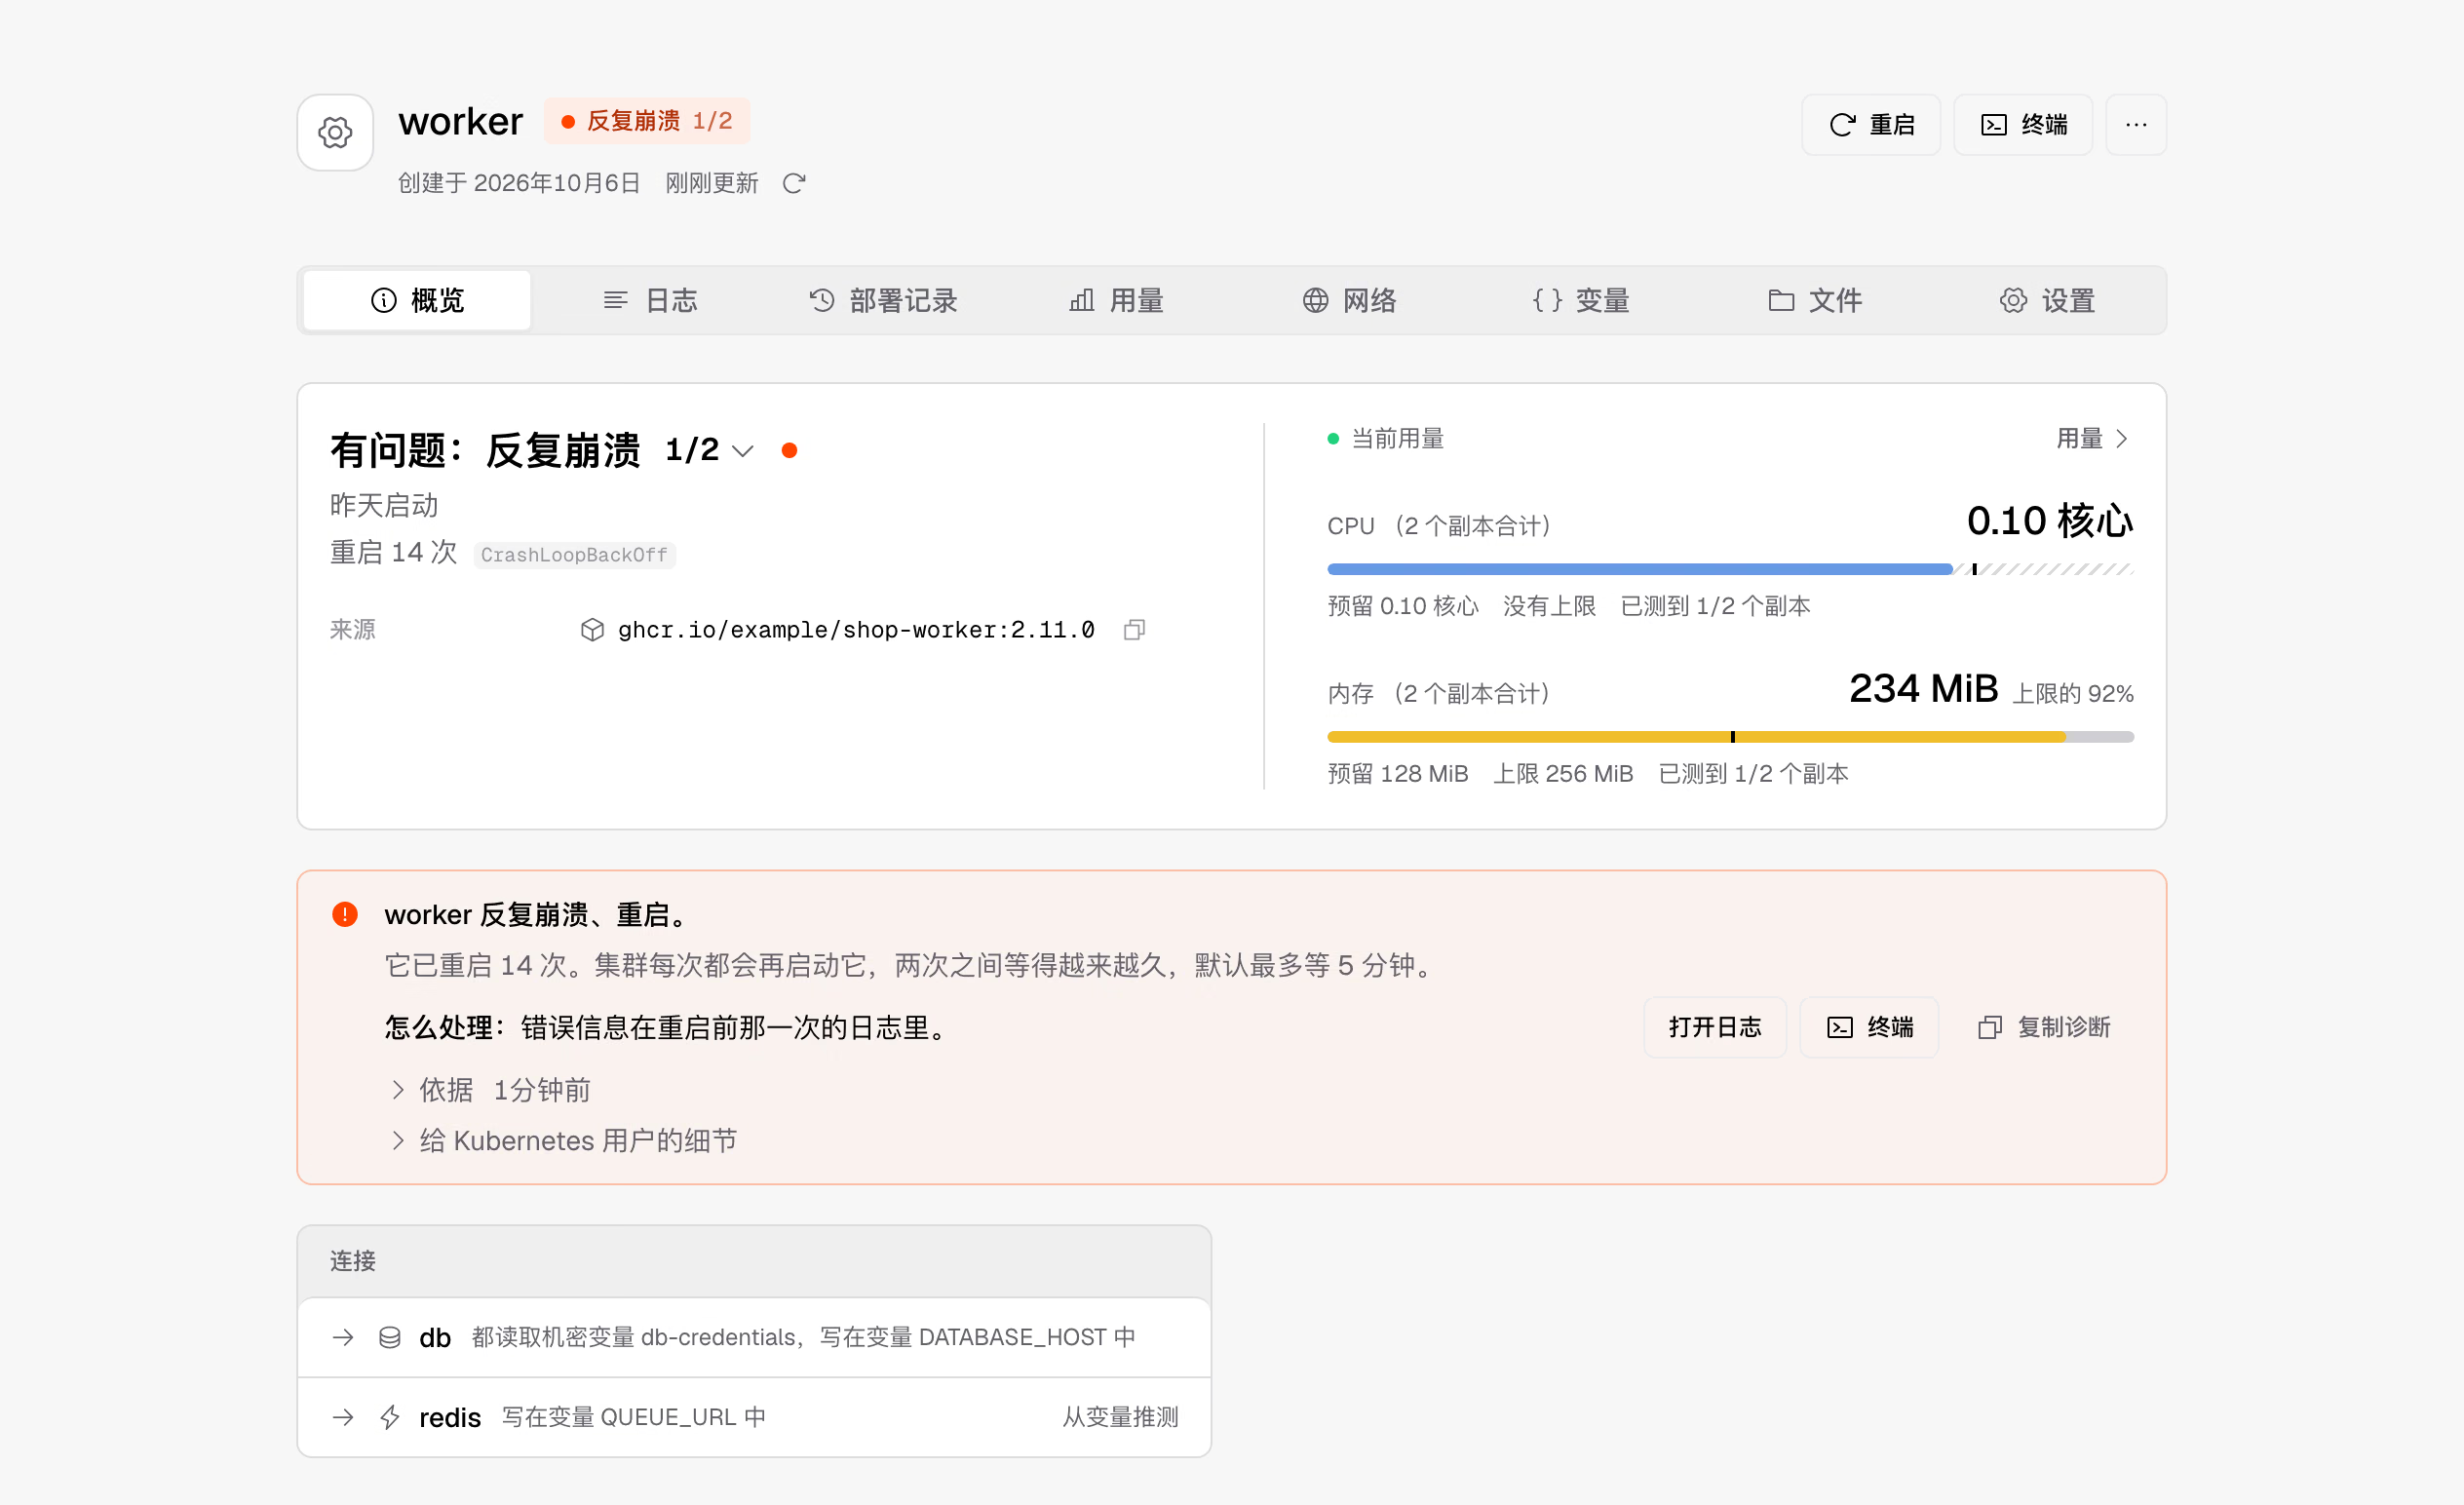
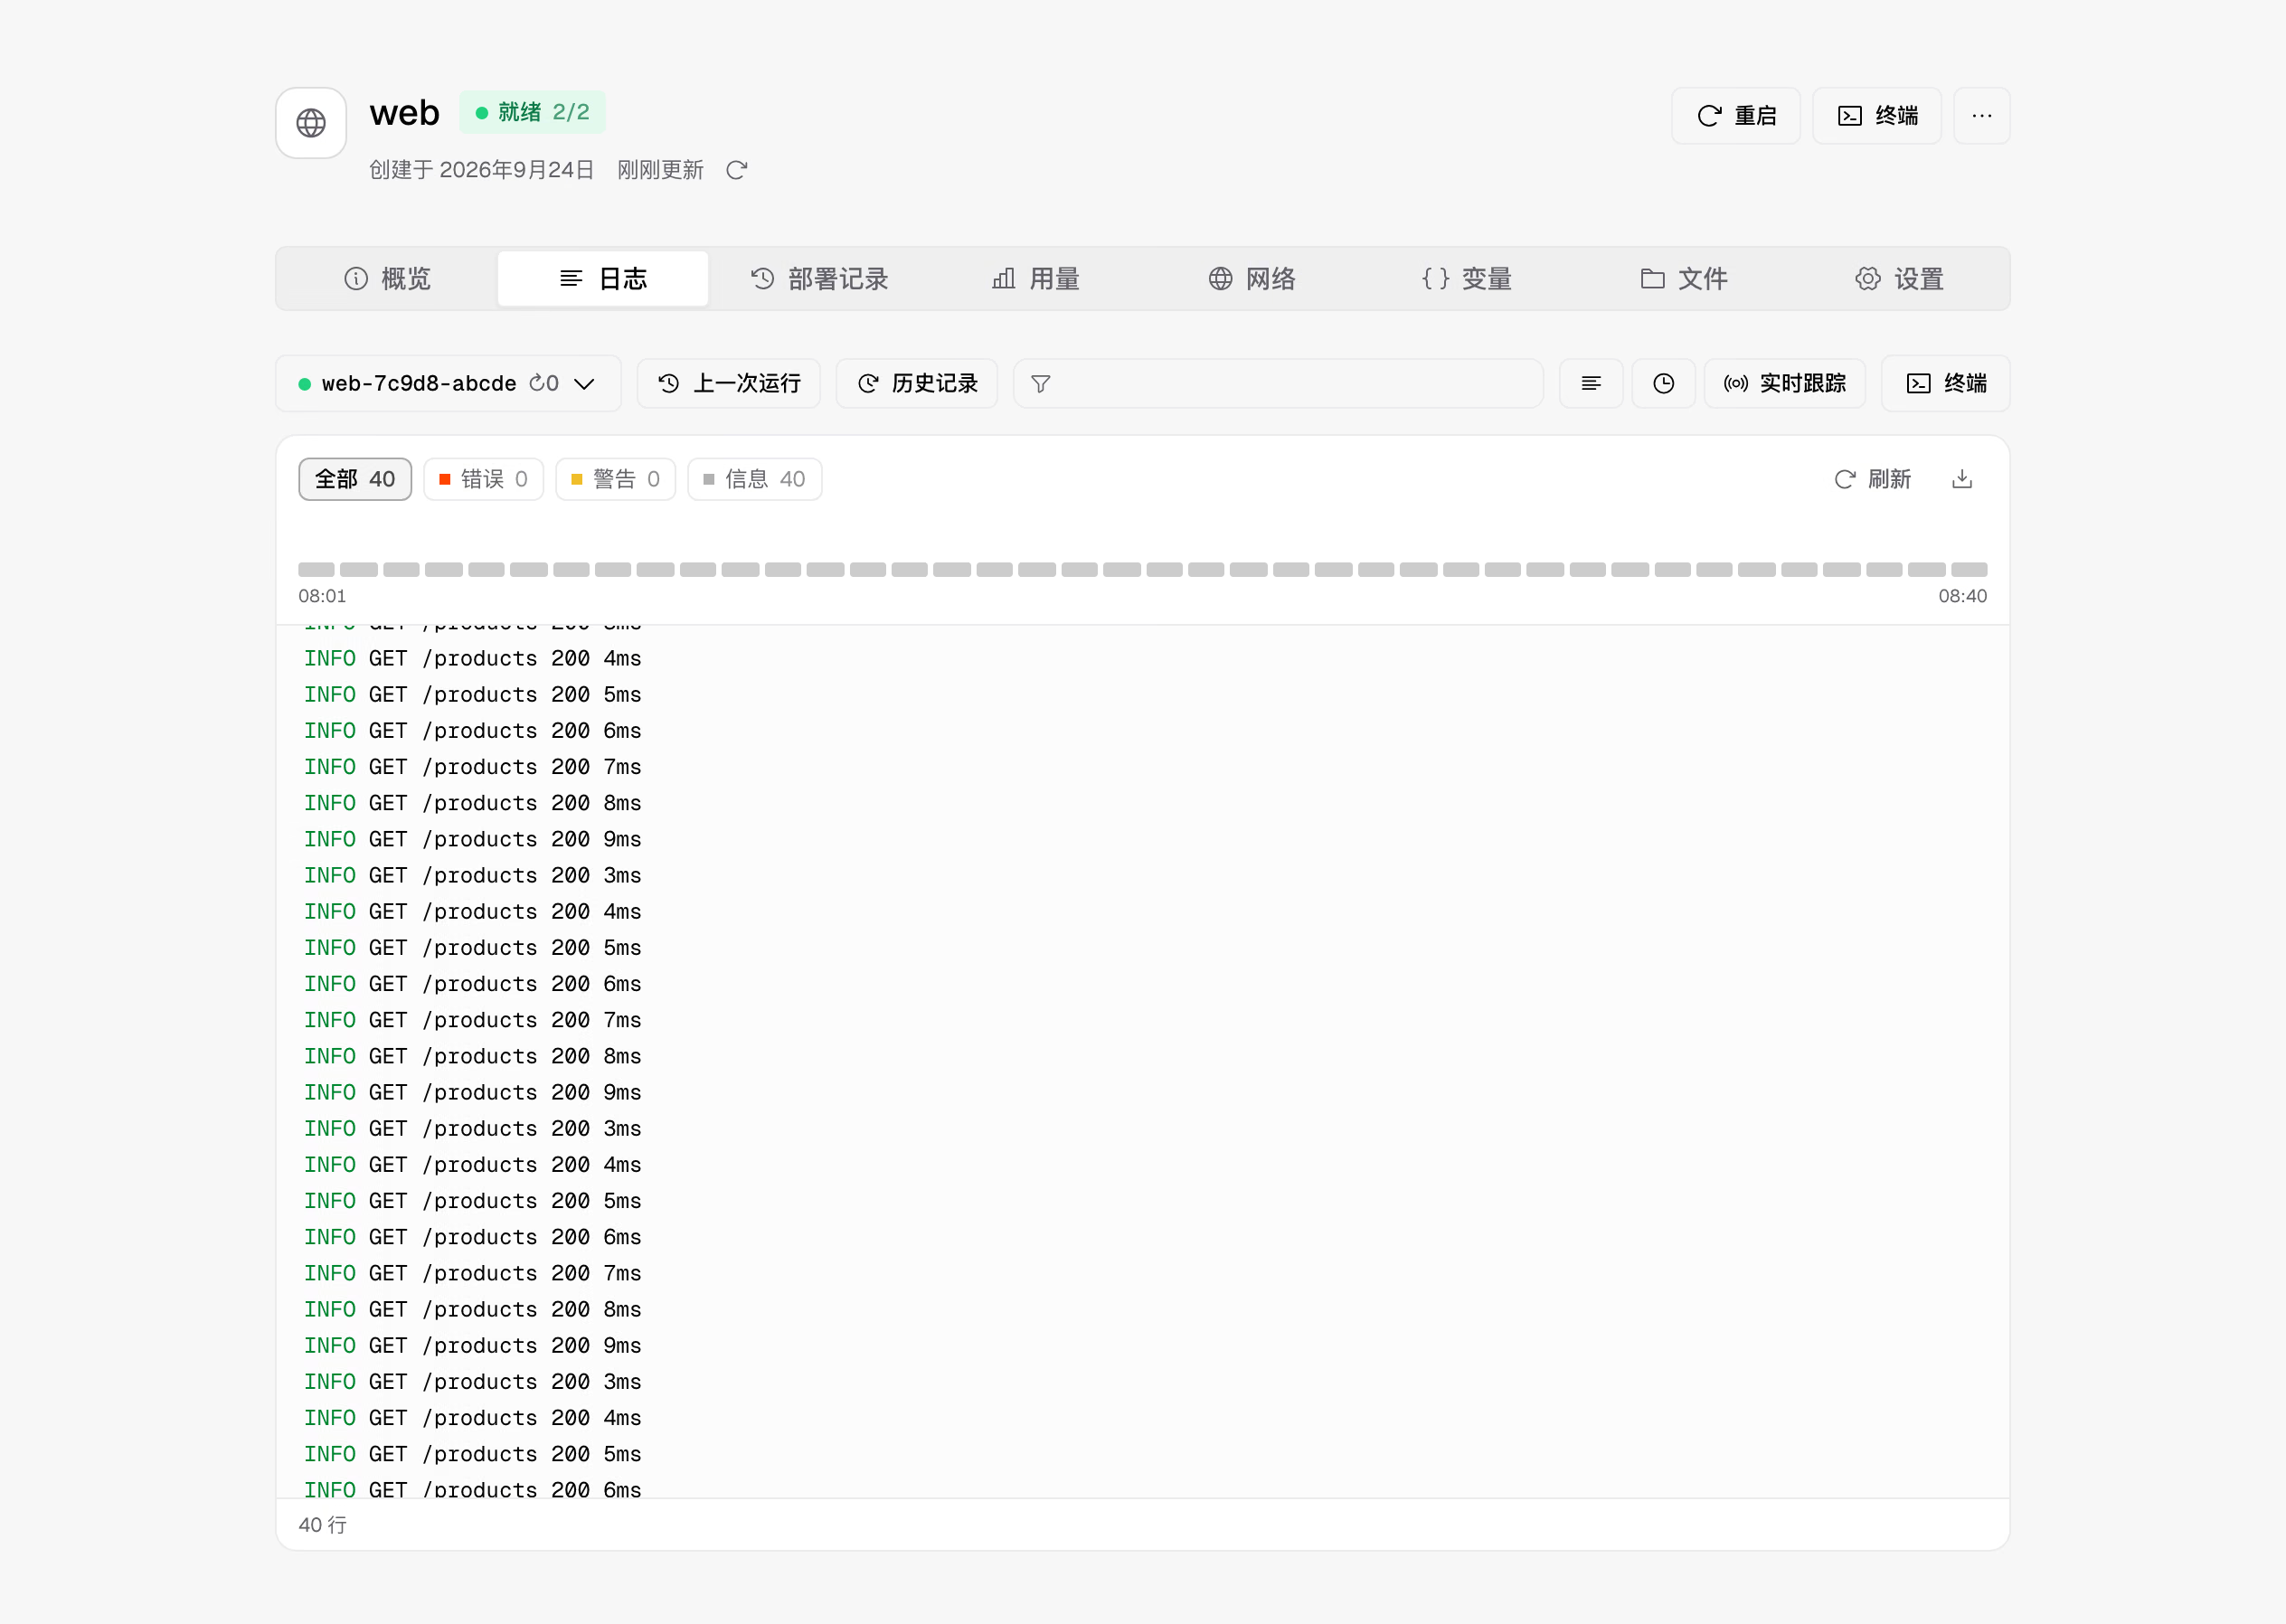
随着实际使用越来越多,我们花了更多时间处理服务上线之后的事:服务反复重启时,把原因、日志和资源用量关联起来;域名无法访问时,顺着流量经过的路径,找到需要检查的地方。我们把 Kubernetes 的事件和状态整理成诊断信息,让服务页面除了说明问题,也能告诉用户接下来可以怎么处理。
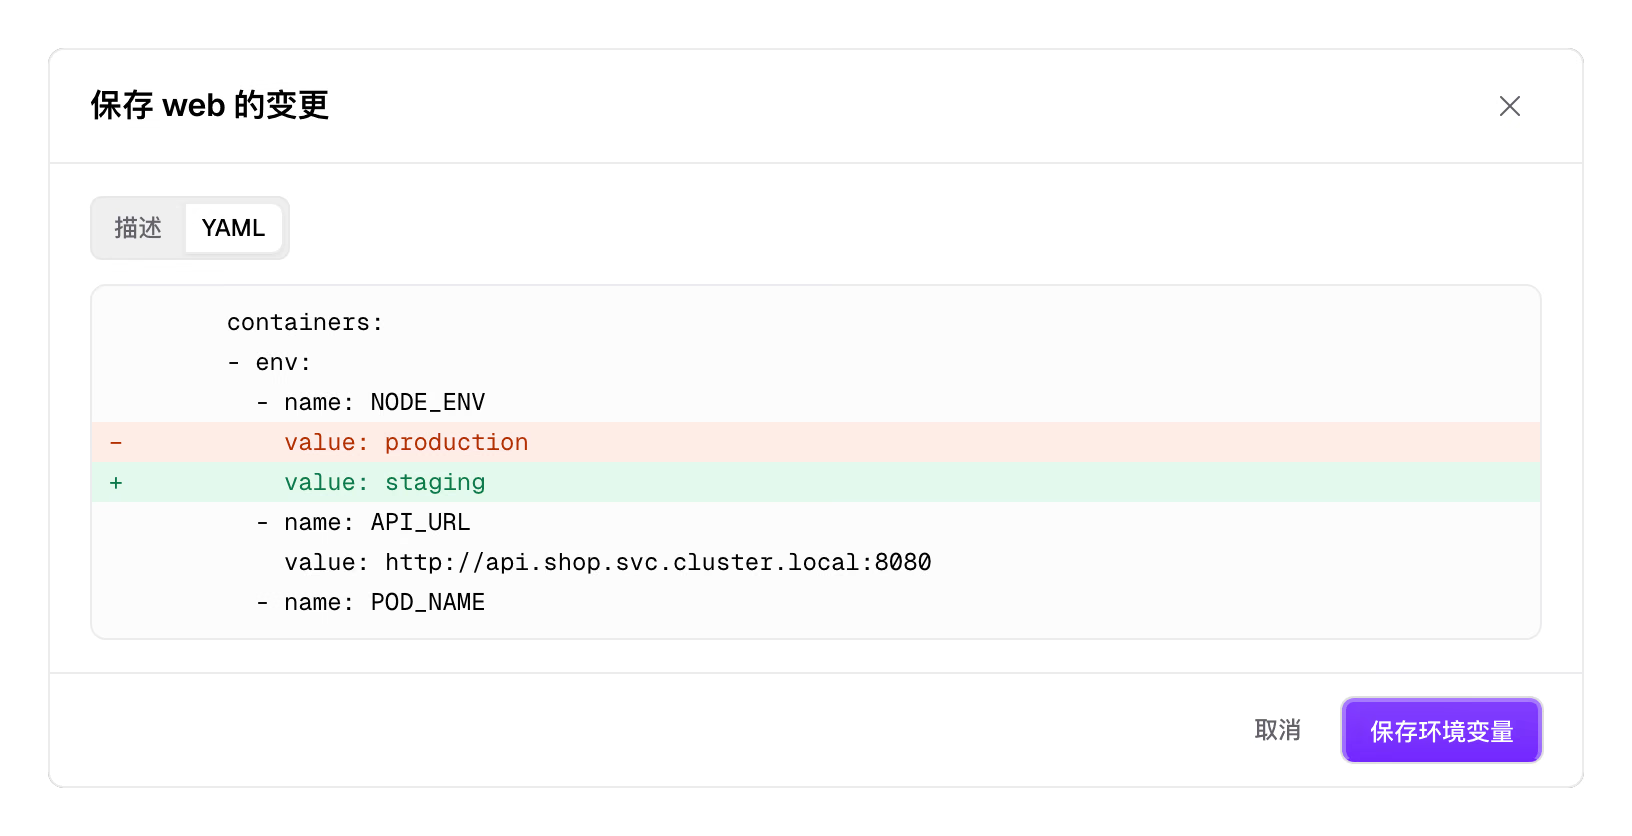
新版本还没部署成功时,旧版本可能仍在提供服务,界面需要把这两件事讲清楚;原因相同的消息,应该归并在一起,让人先找到要处理的问题。多人协作时,你正在调整副本数,同事可能同时在更新镜像,所以我们做了“检查变更”:先看要修改的内容,确认后再应用;如果这段时间里对象已经被改过,就重新读取当前状态。由 Helm、Argo CD 或 Flux 管理的配置,也会标出来源,方便回到原来的工具里修改。
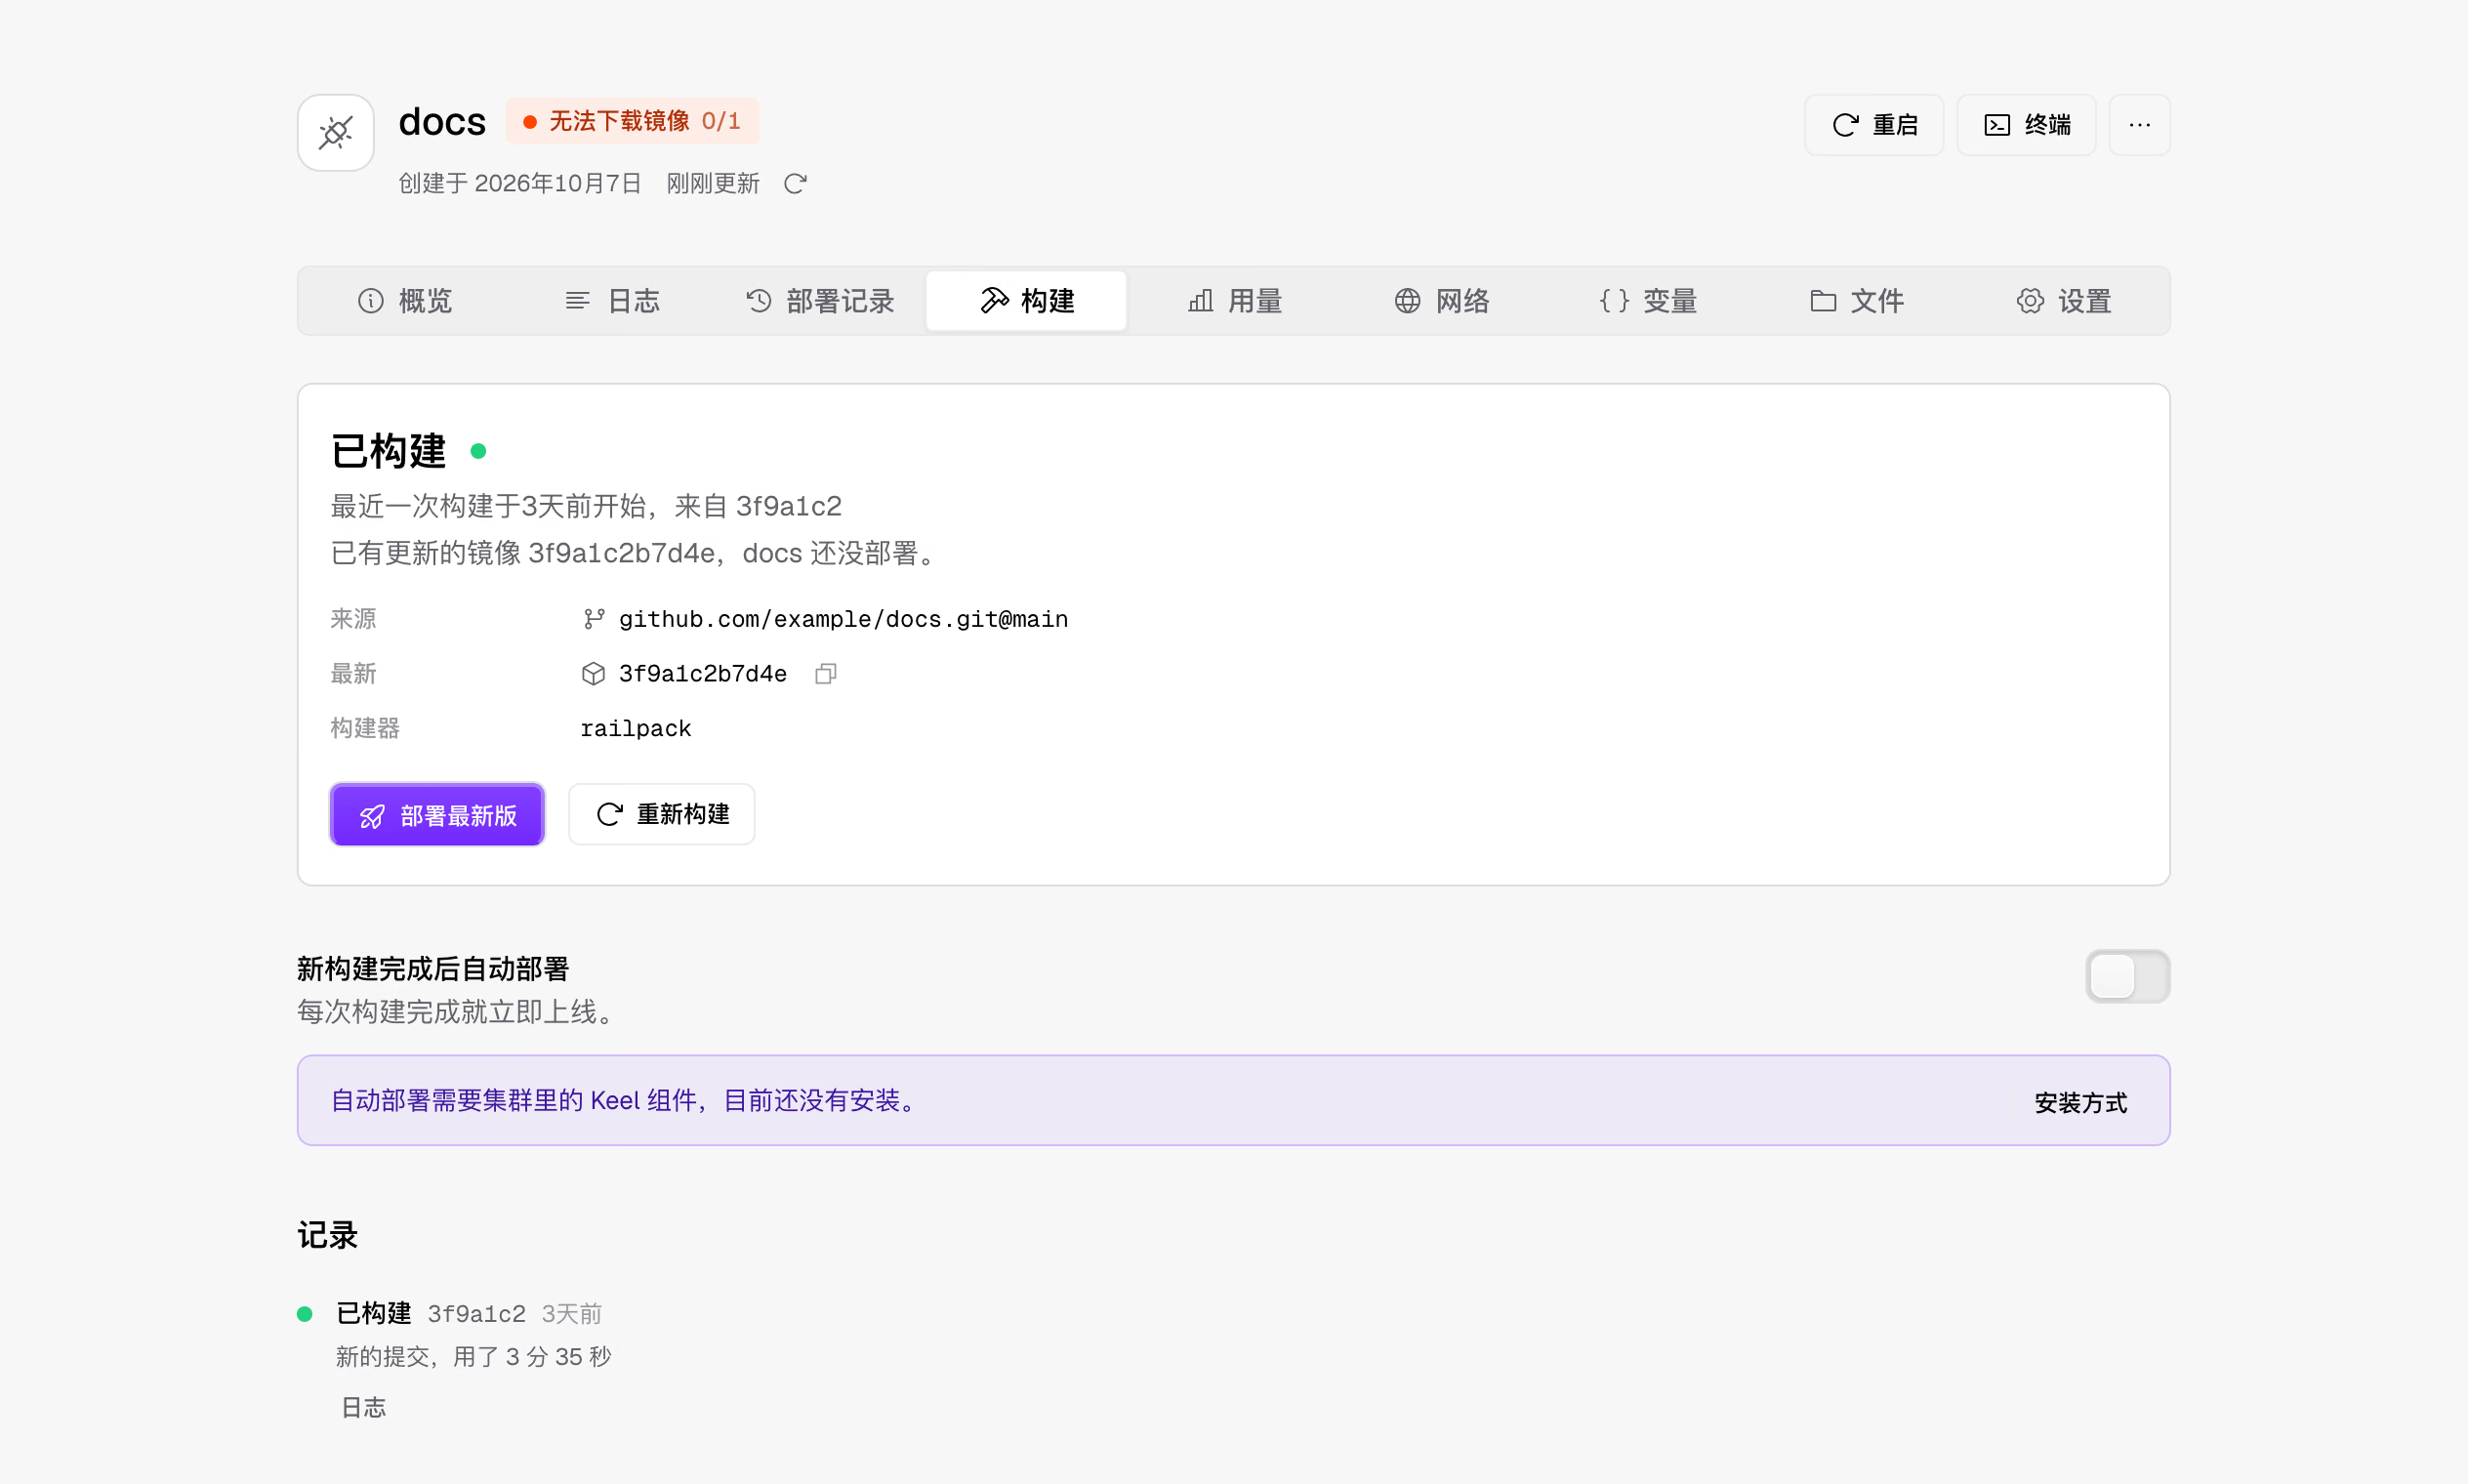
部署的应用多了,接下来要处理的是构建。从 Git 提交代码、生成镜像,再部署到服务,是很多 Zeabur 用户已经习惯的工作方式。我们保留了这个流程,另外做了独立的 Zeabur Builder:把各个项目的构建环境和缓存隔离开,梳理构建所需的网络和存储权限,并通过 BuildKit 的 secret 机制传入构建变量。
接回界面之后,用户可以选择 Dockerfile 或 Railpack,配置仓库、构建目录和变量,在记录里查看结果,再决定自动部署还是手动让新版本上线。沿着这个流程操作,我们也能检查代码从仓库到实际运行之间,还有哪些地方说不清楚,或者多了不必要的步骤。
AI Agent 协助完成了大量研究、实现和测试工作,也让这些实验可以更快地反复尝试。但产品要怎么用、哪里值得继续改,仍然需要我们亲自操作和审查。有时功能已经做完,卡住人的却是一个看不懂的名称,或者不知道下一步该点哪里。
从第一台服务器,到数据的长期维护
服务管理做得差不多之后,问题又往前后延伸:手上只有一台服务器的人,要怎么开始?部署完成后,数据怎么保存,出了问题怎么恢复?自托管需要处理这些事,所以我们也加入了安装工具、组件选择和备份流程。
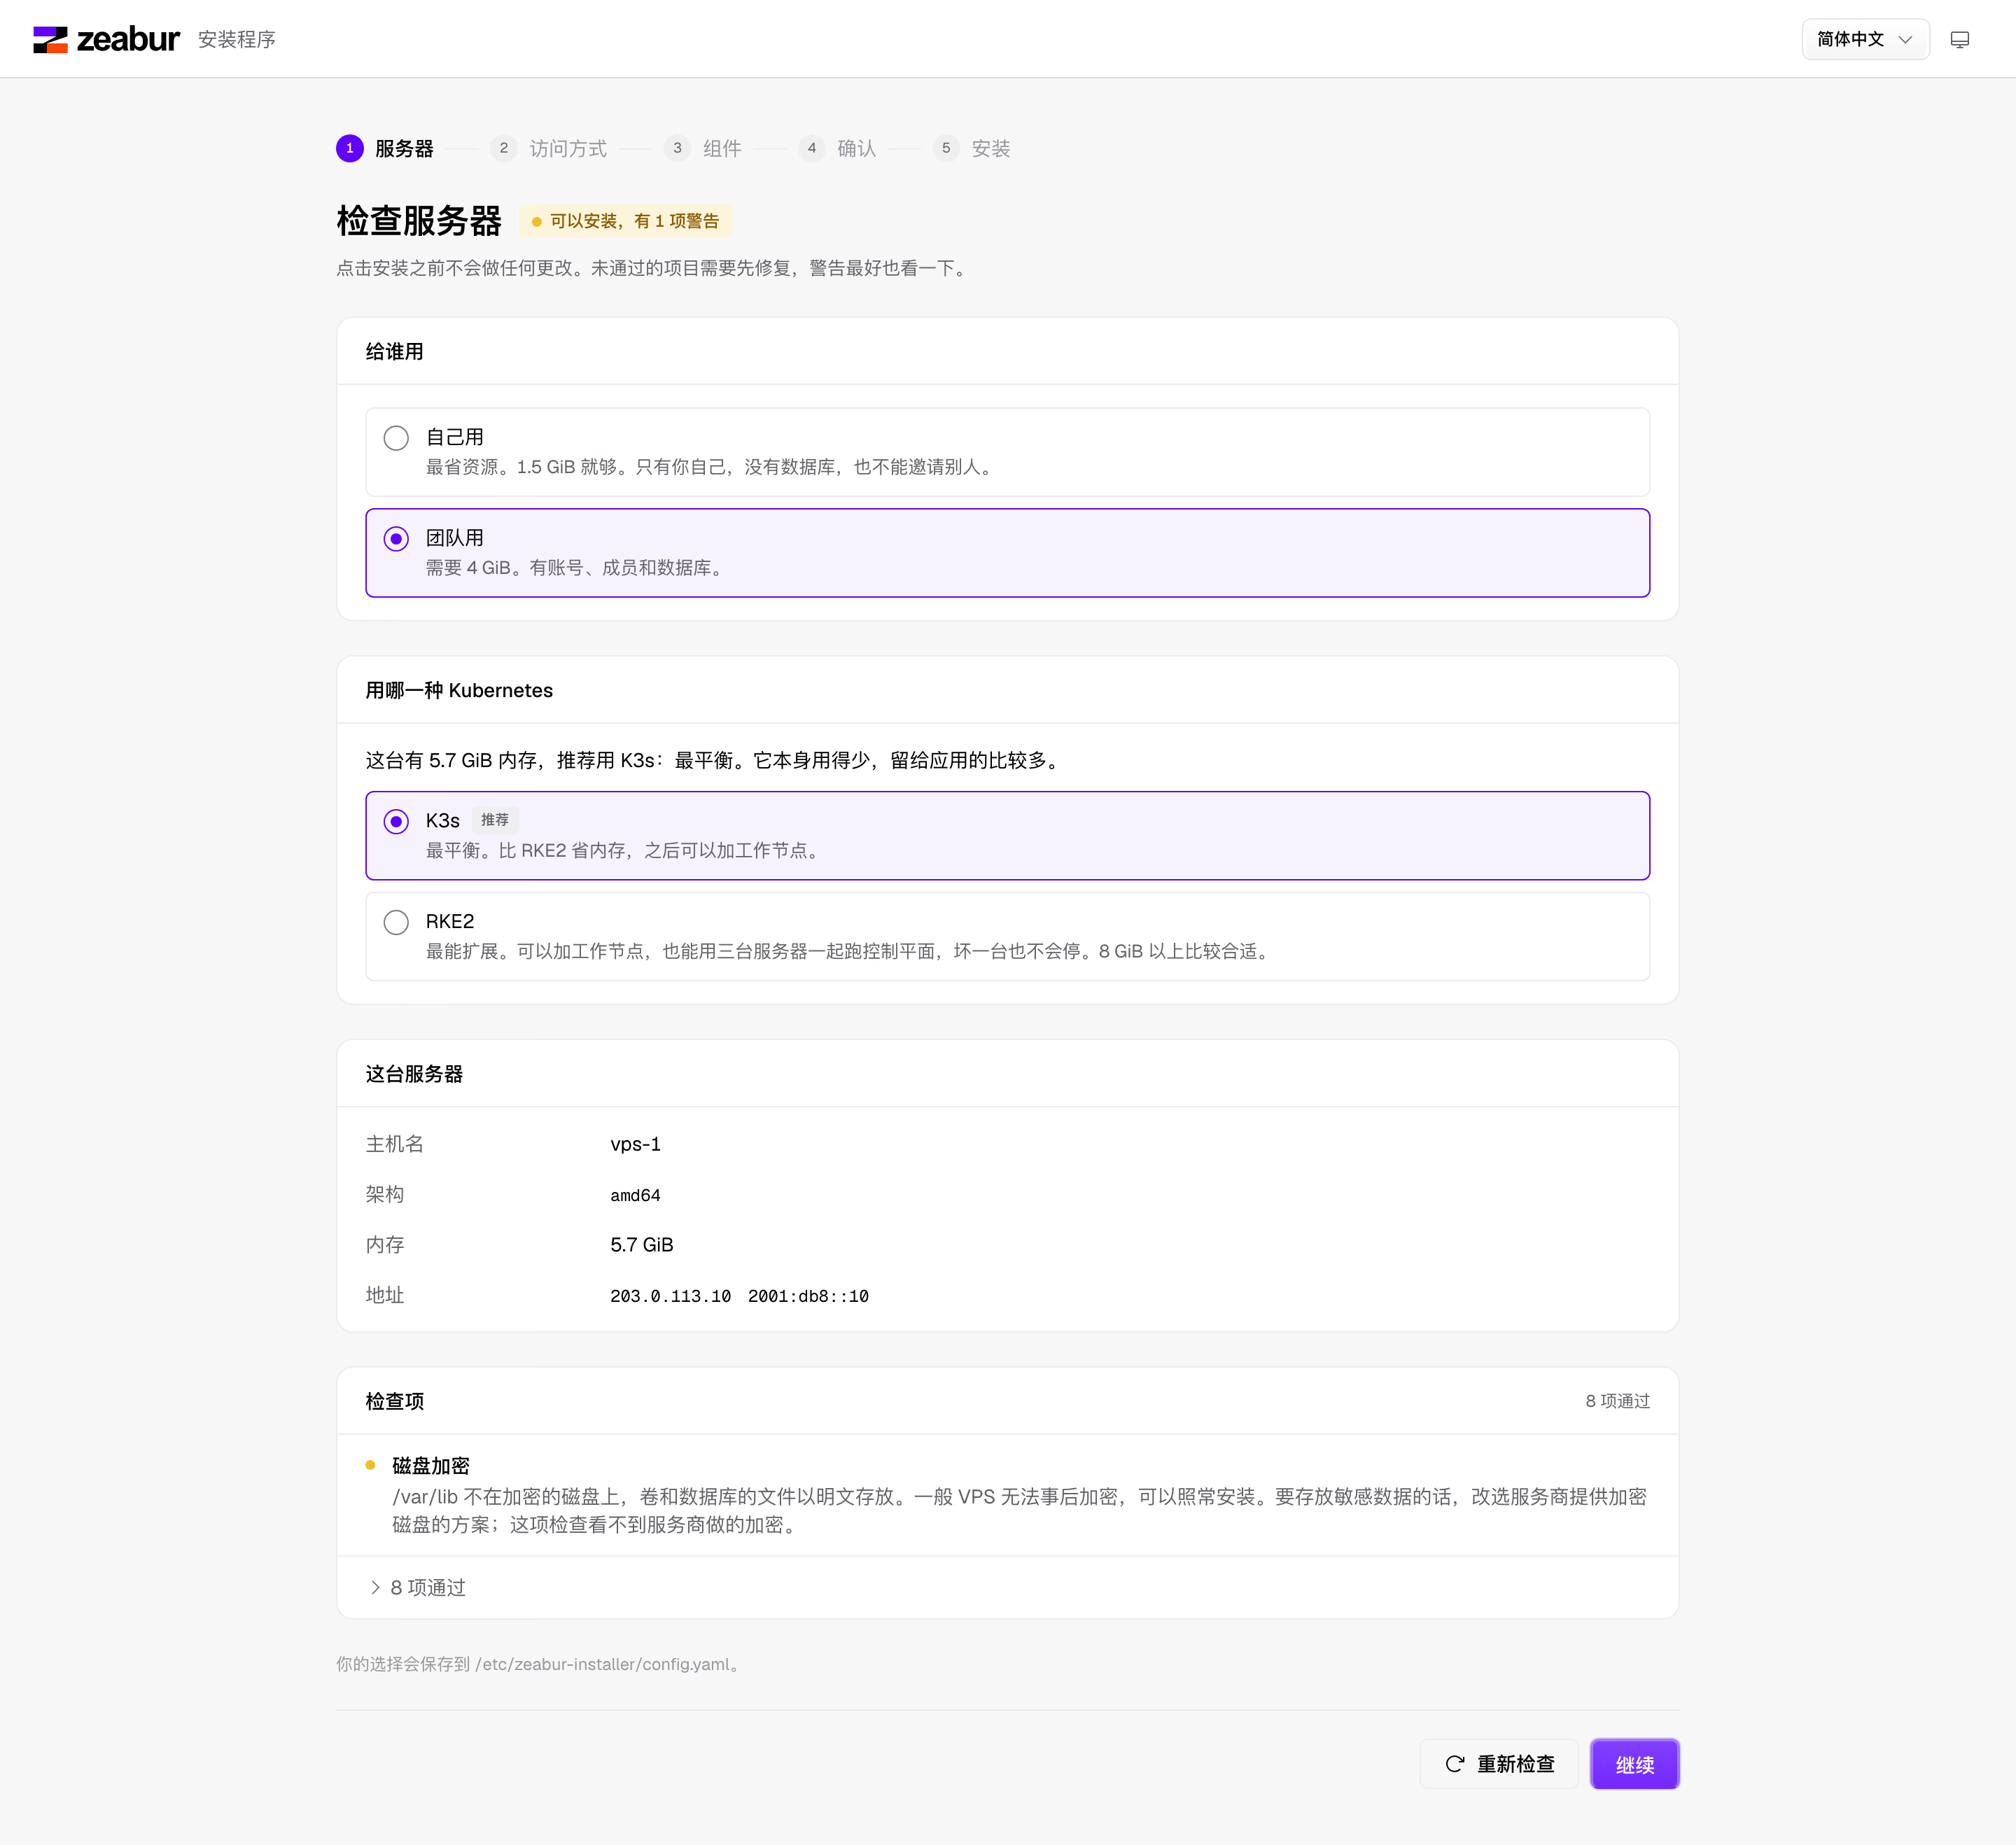
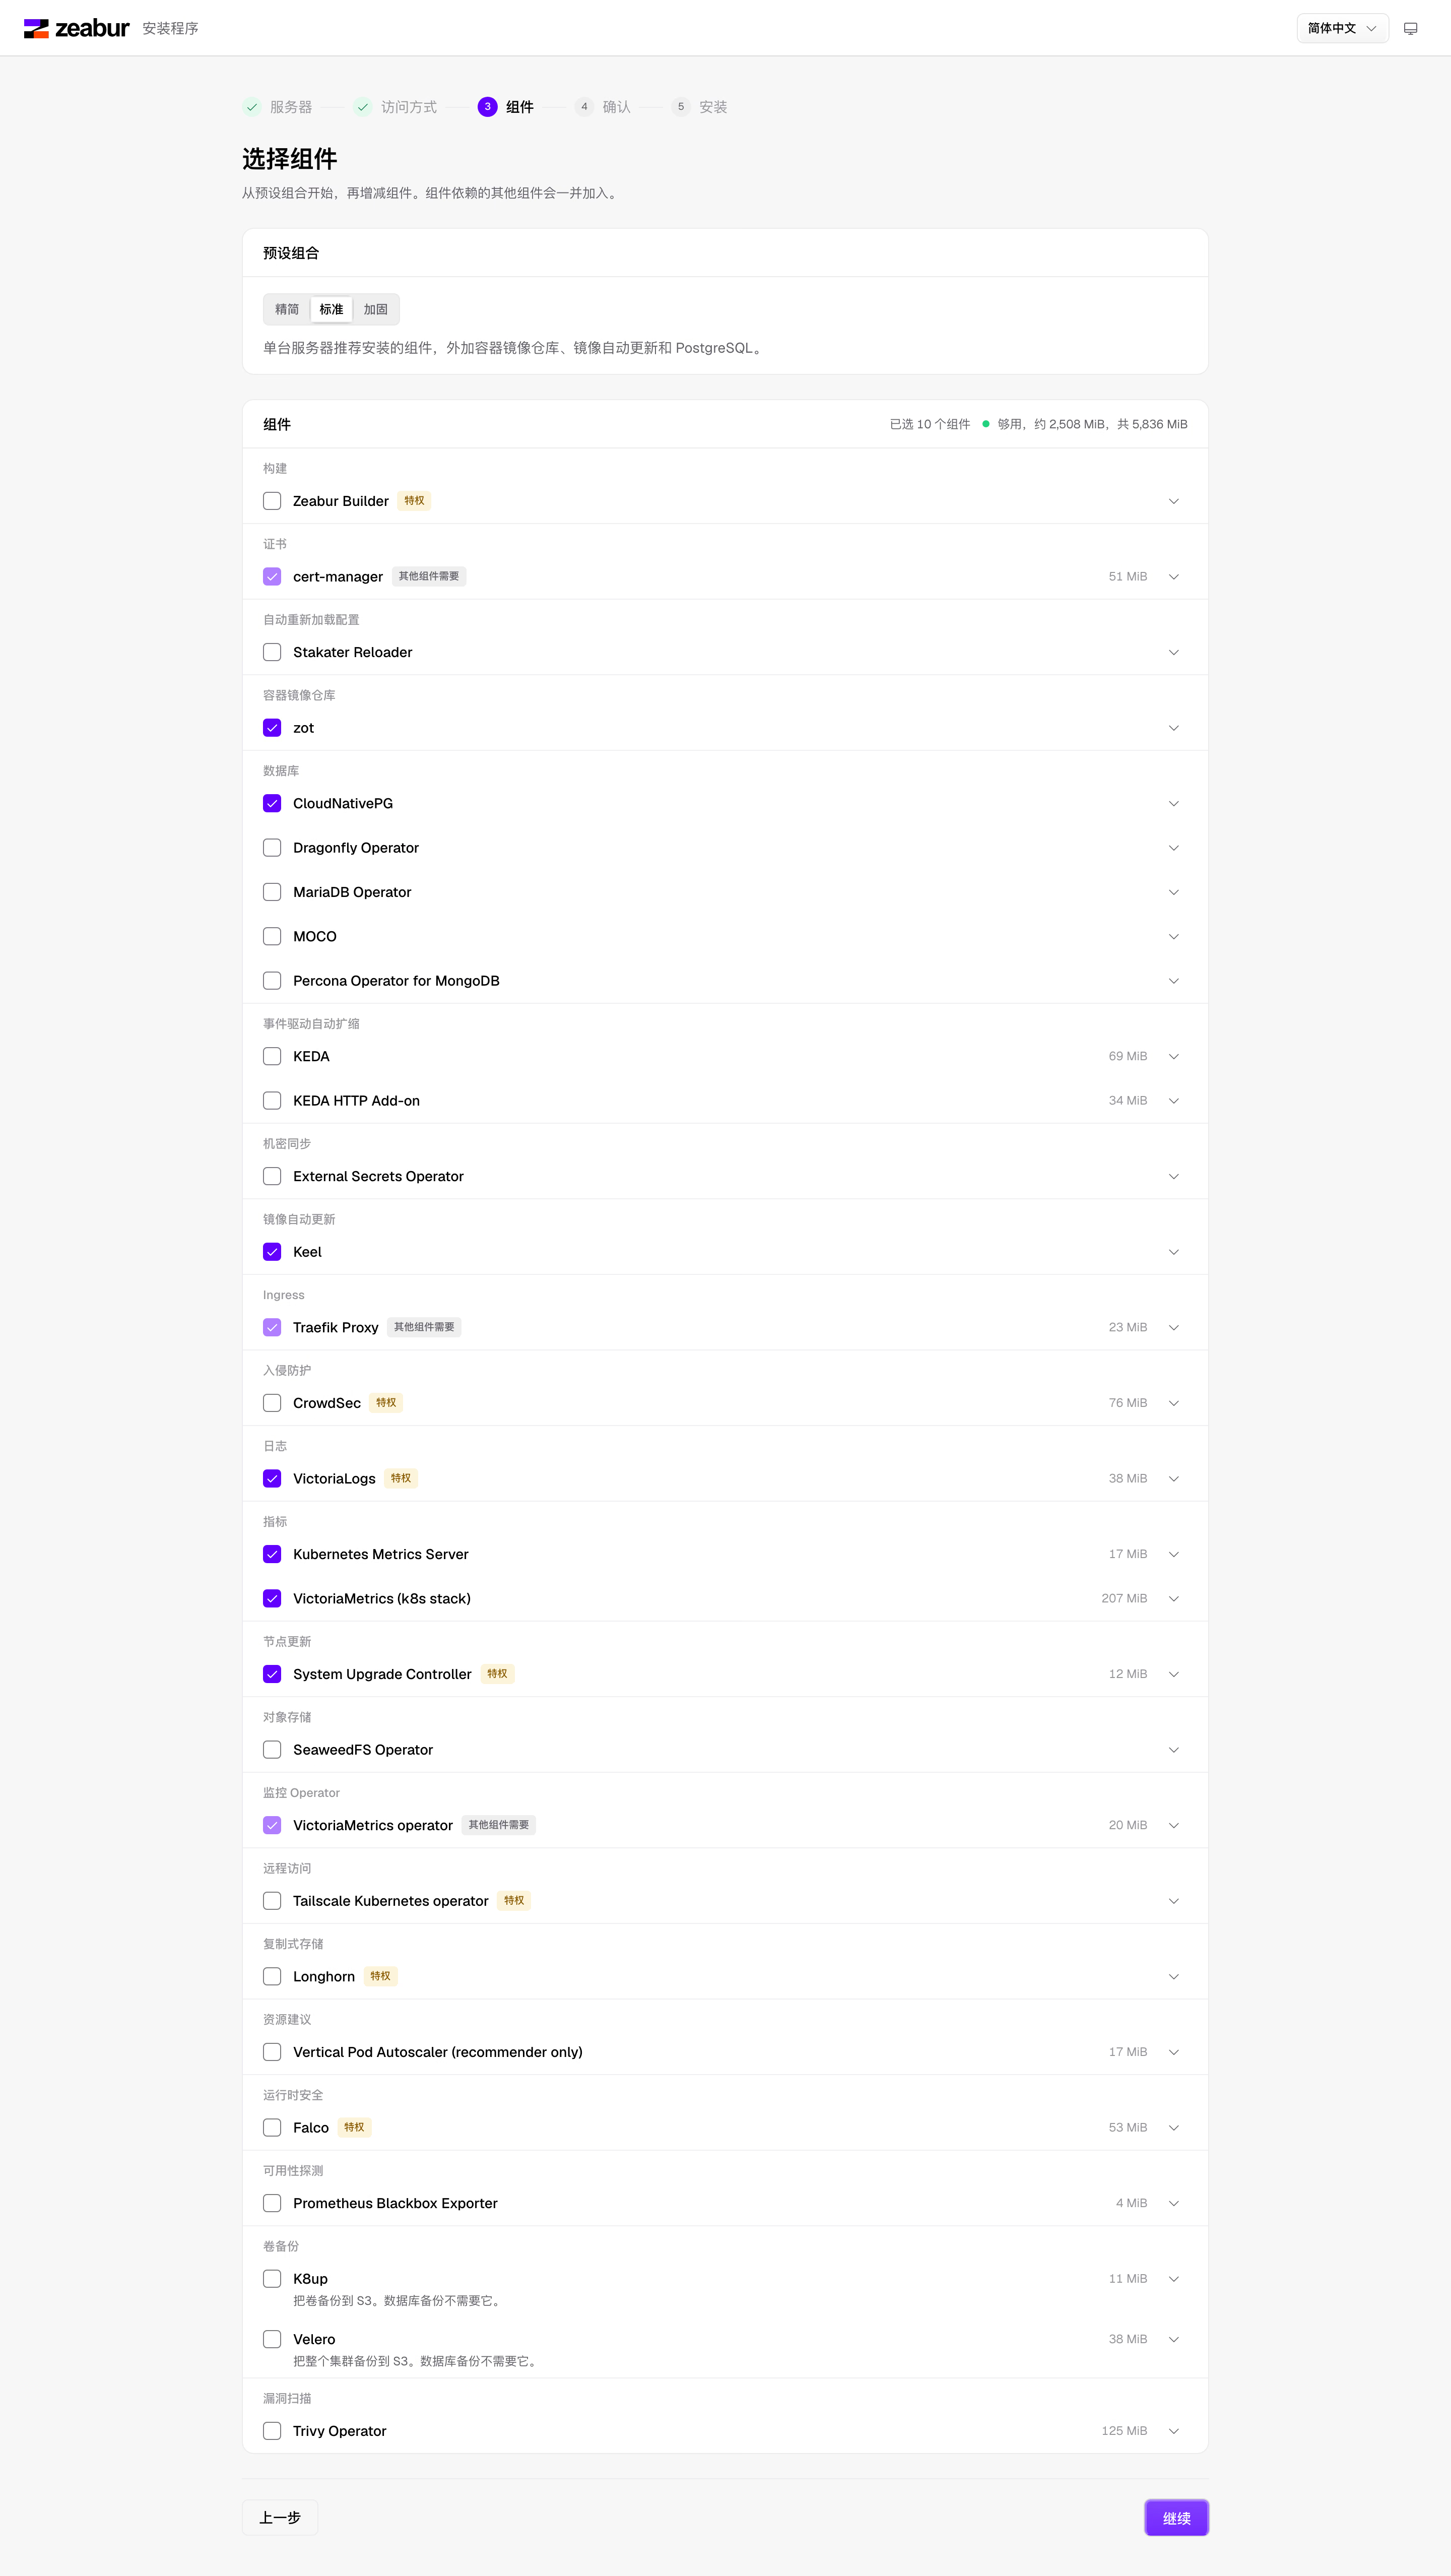
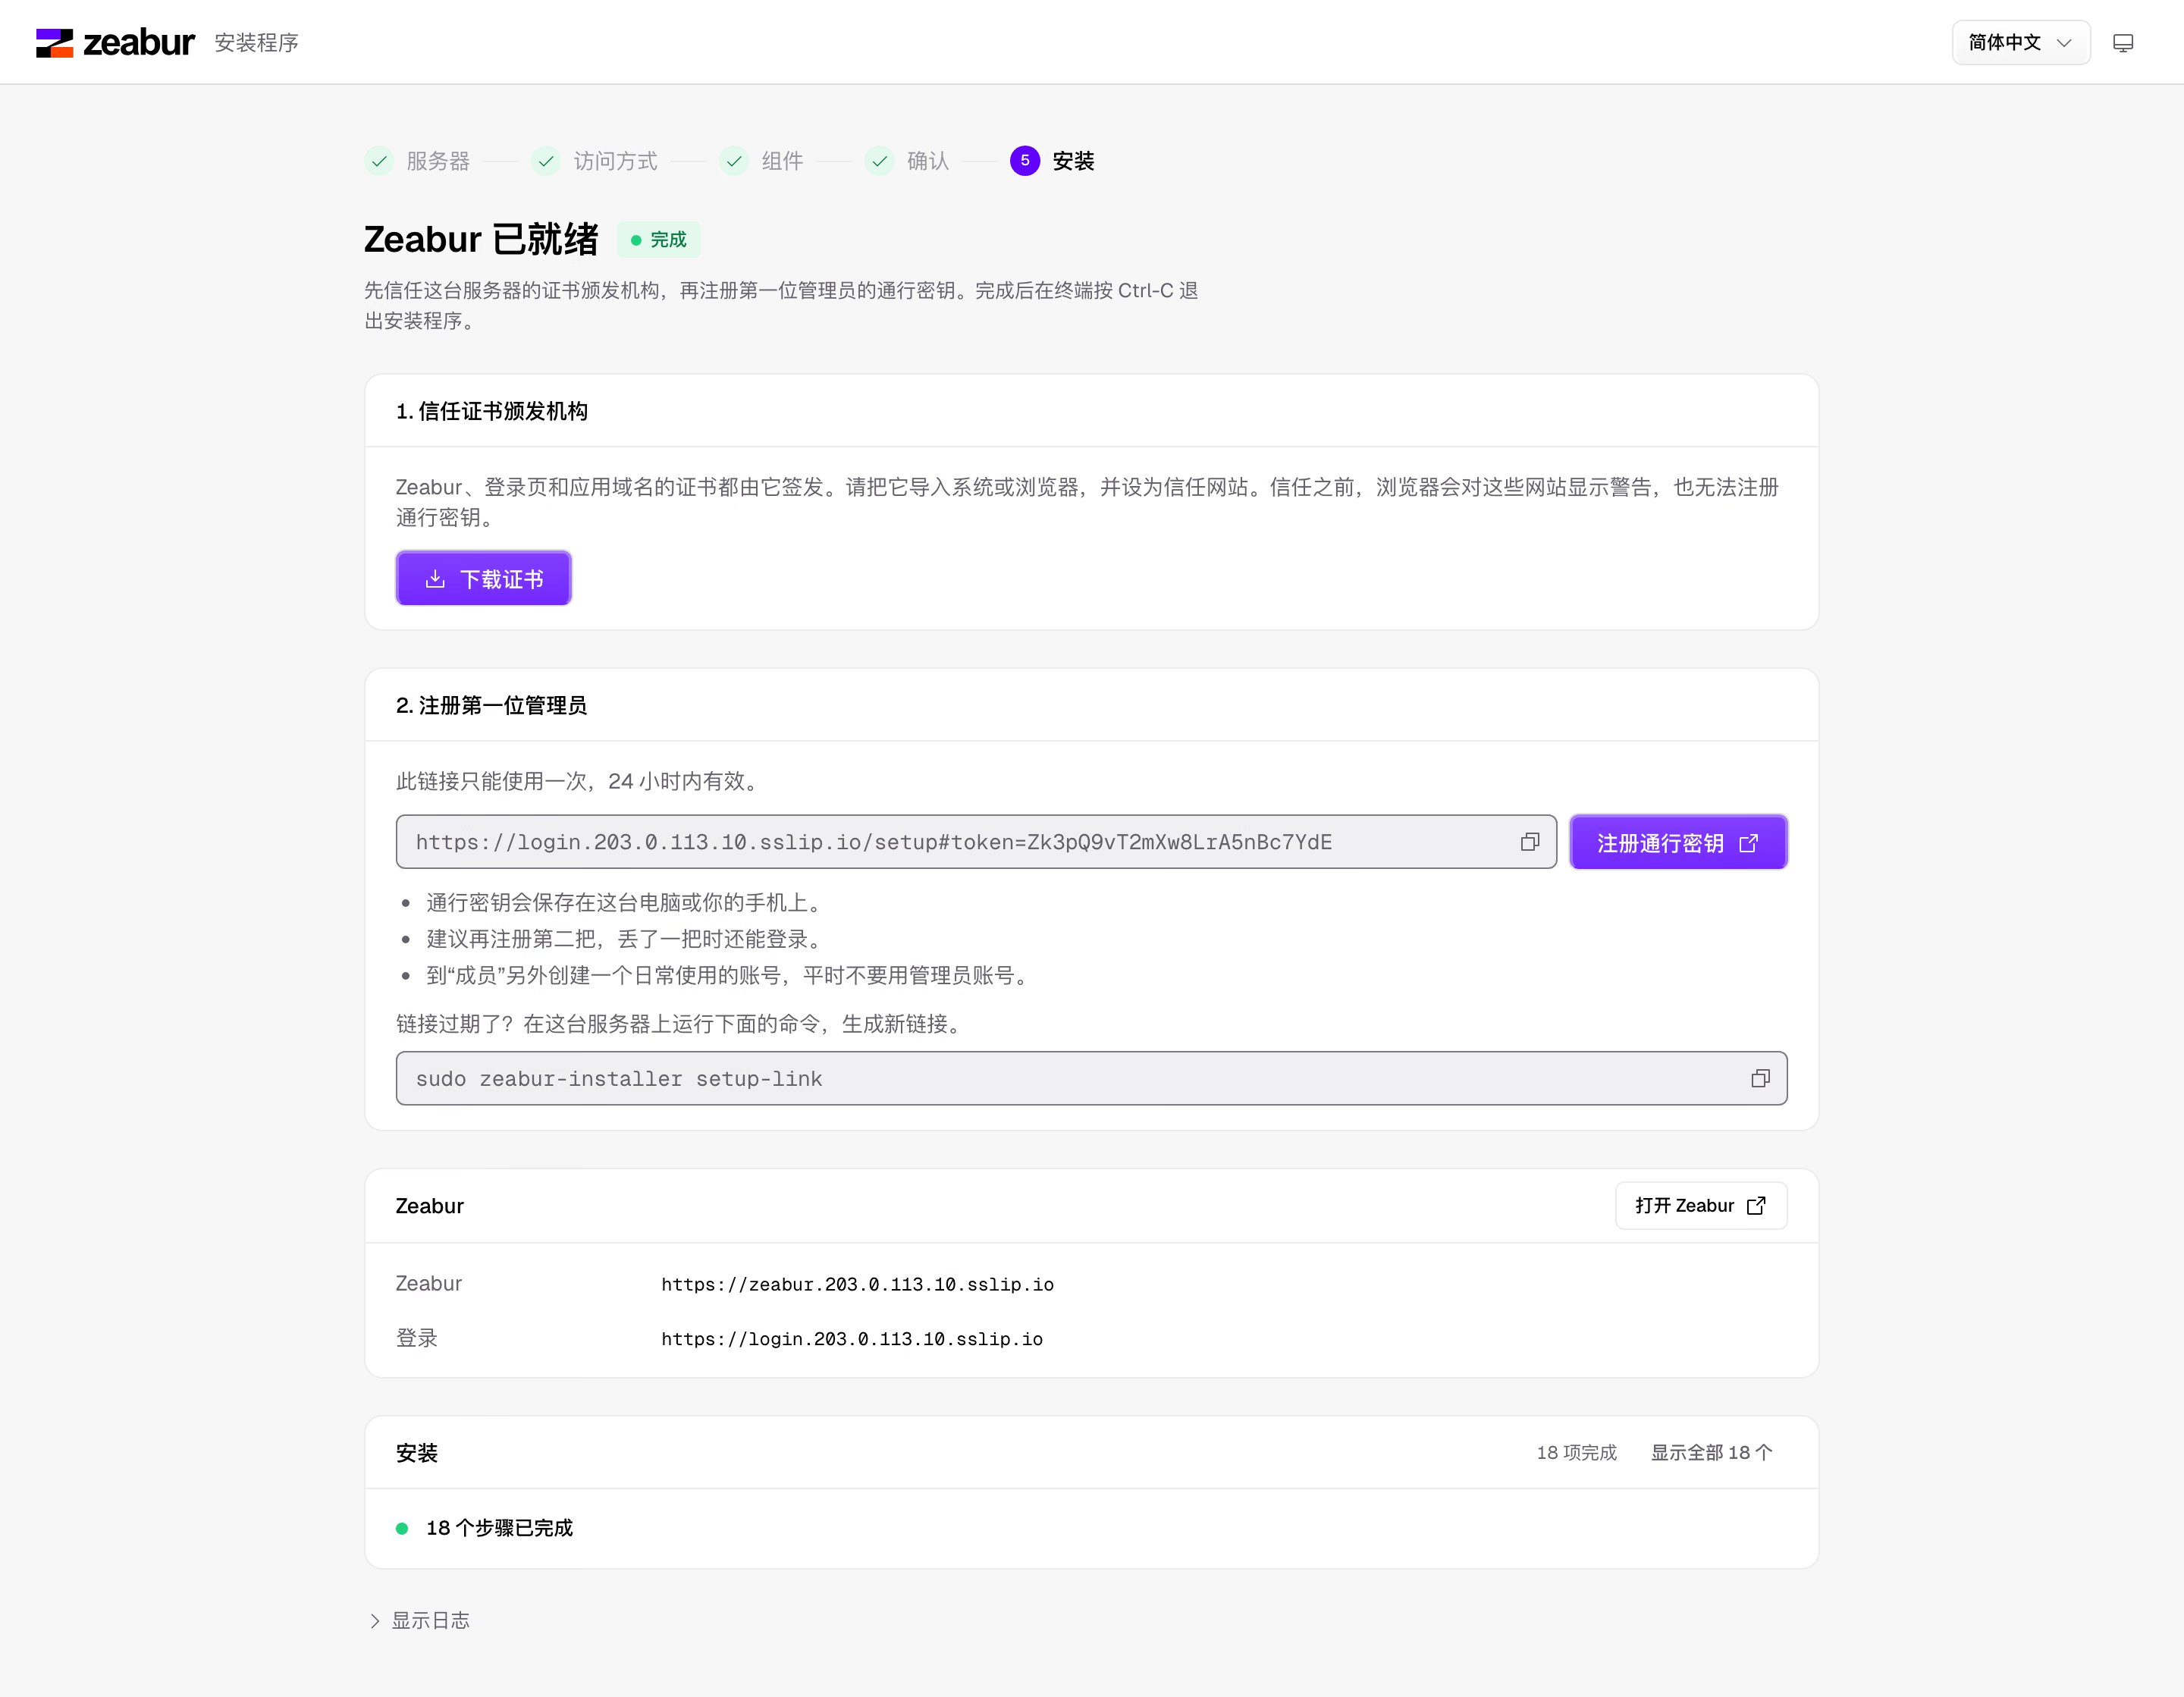
Zeabur Installer 把准备环境的经验整理成网页流程:先检查主机、磁盘和端口,再设置访问地址、选择组件,确认资源需求和安装内容后才执行。Kubernetes 的安全配置、Secret 静态加密,以及监控和安全组件的选择,都放进了这个流程。安装完成后,接着注册第一位管理员的通行密钥,就能打开 Zeabur、创建第一个项目。
应用模板则让我们重新研究数据和维护的细节。n8n、Dify、WordPress 这些熟悉的应用,各自有不能丢失的数据、备份需要包含的内容、升级步骤,以及增加实例的条件。我们把研究结果和部署配置整理进 Zeabur Catalog,把集群共用组件分开管理,让从模板开始的部署,后续也有可以查阅和修改的依据。
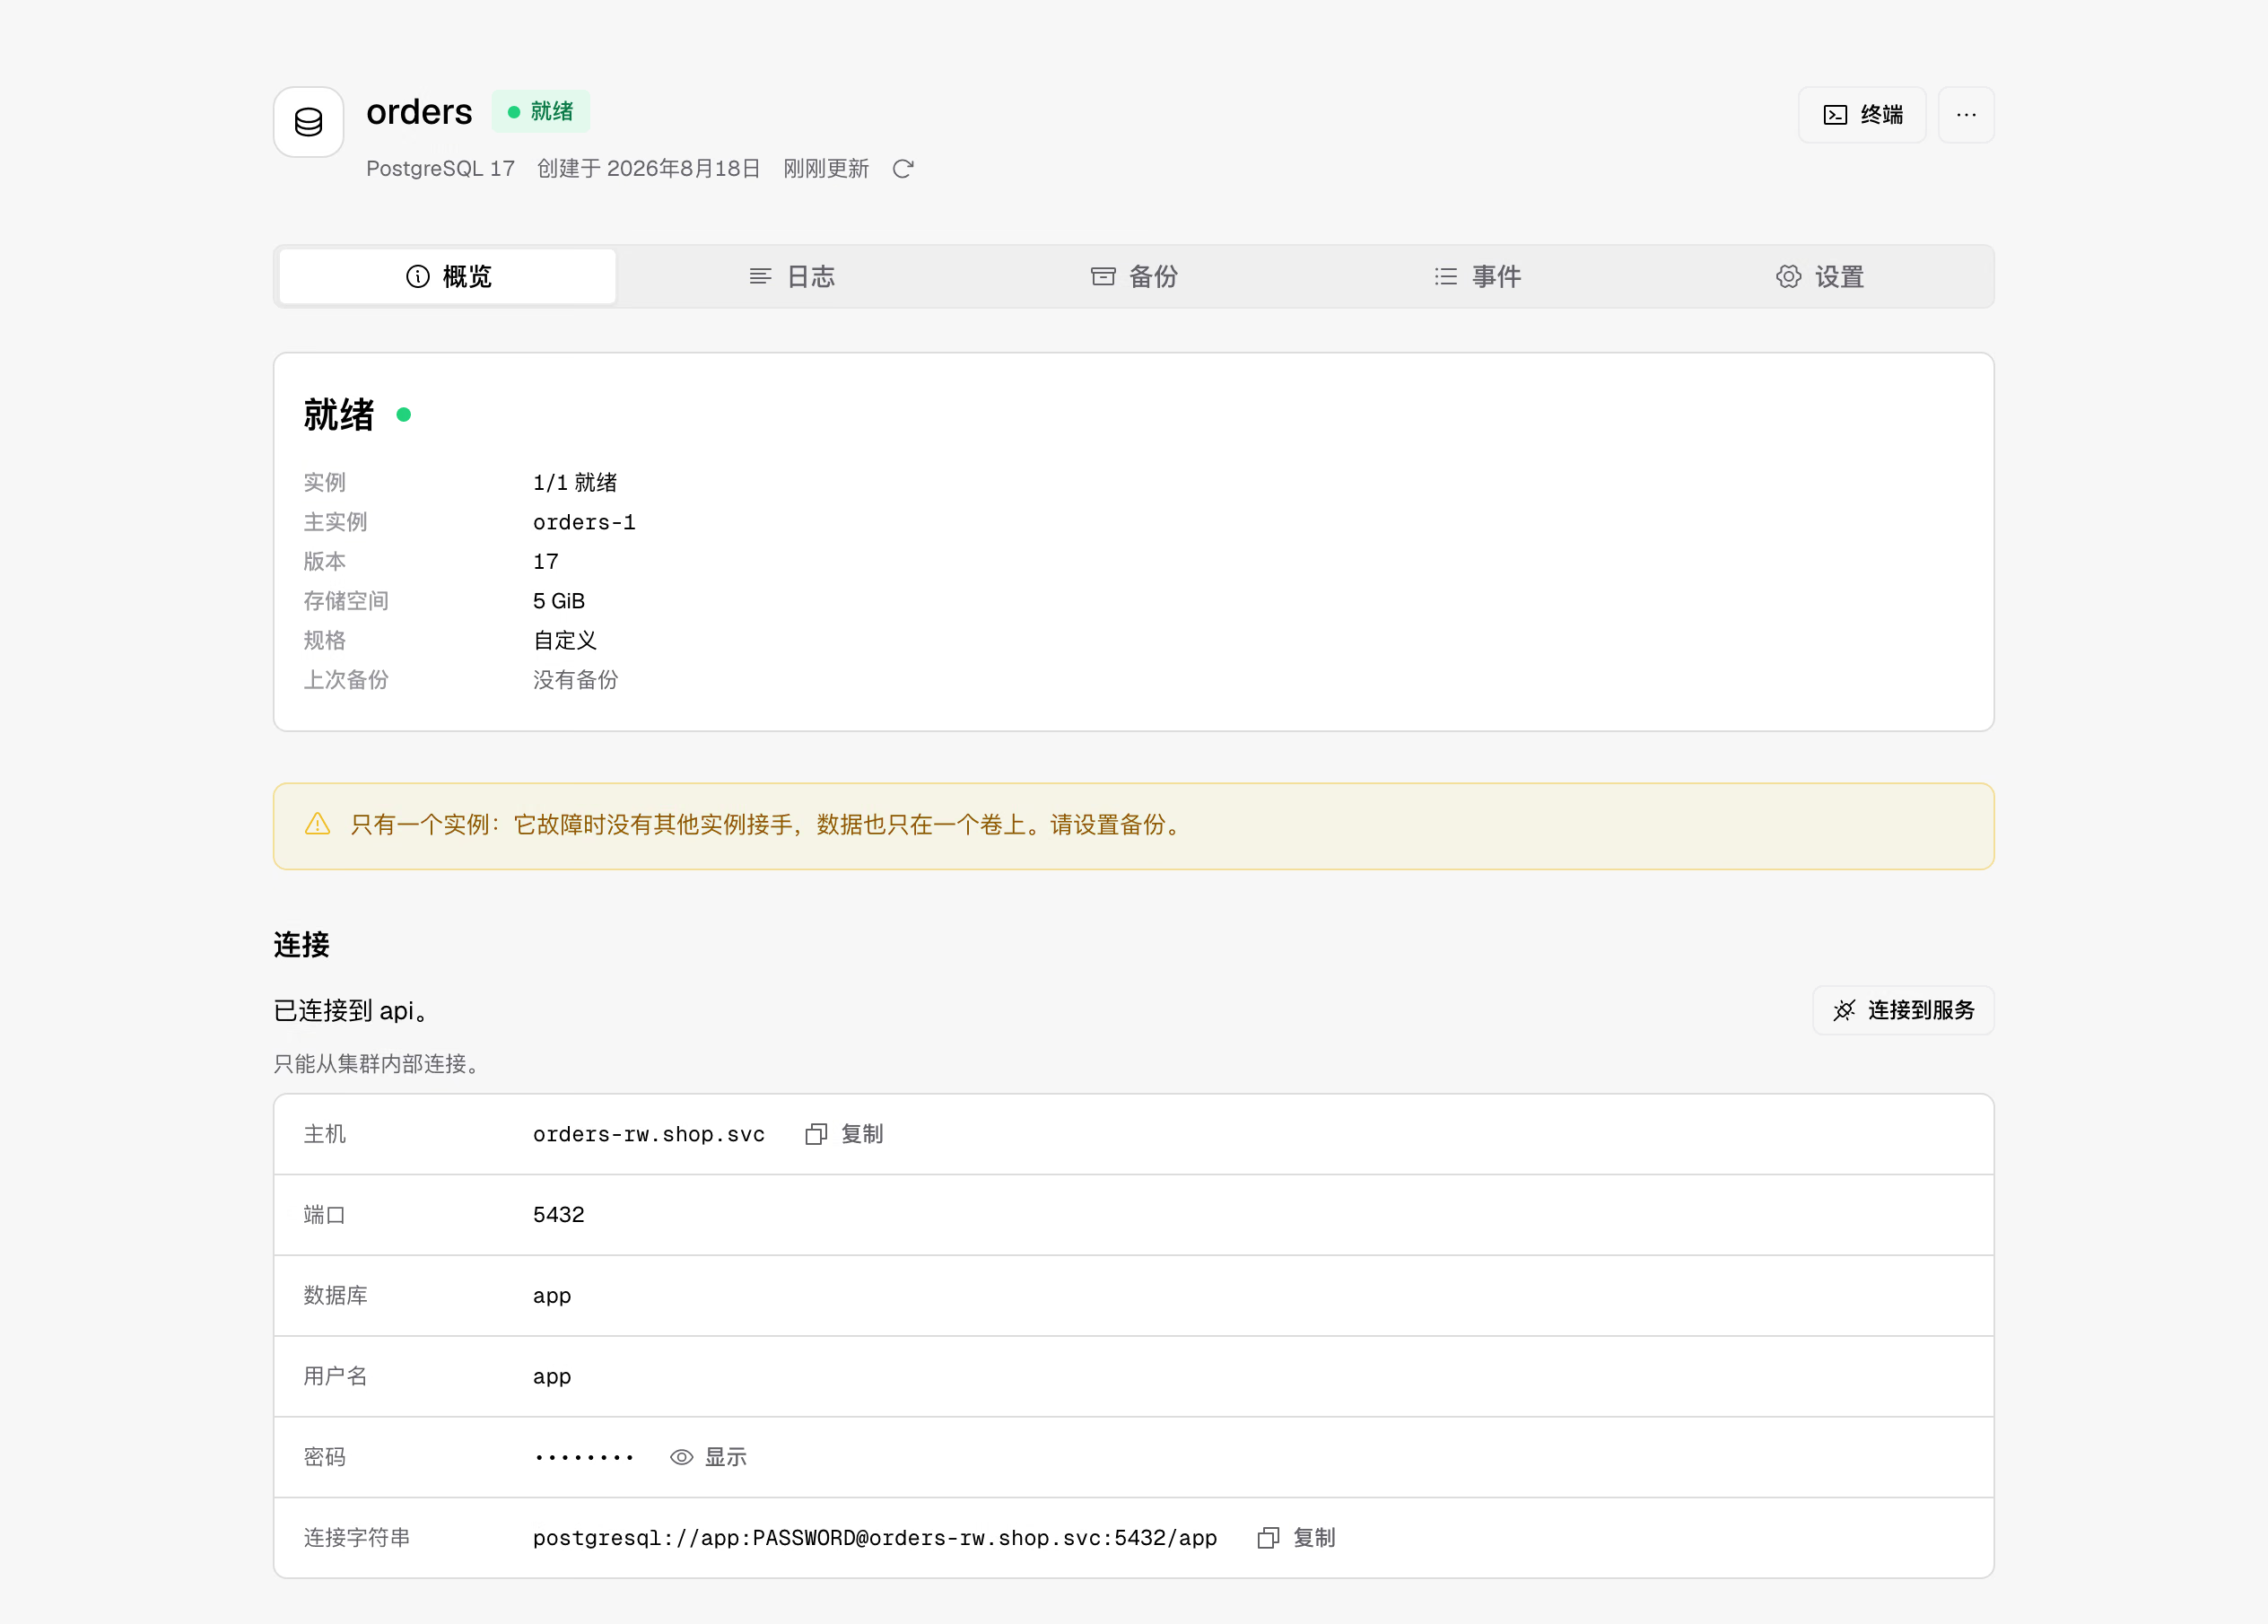
数据库的操作从创建、连接,一直延伸到备份与恢复:通过对应的 operator 创建数据库,把连接信息接到应用上;设置备份目标后,可以查看执行结果,需要时恢复成一个新的数据库,先确认内容,再安排服务切换。存储卷和集群备份,也分别接入了合适的工具。用户真正需要恢复数据的时候,手头通常已经有很多事要处理。把来源、目标、状态和步骤提前整理好,能减少当下重新查找的工作。
做到这里,已经可以从一台空服务器开始,一路安装、登录、部署到备份;以前反复讨论的问题,现在可以自己动手用上了,这是整个开发过程里最有成就感的时刻。
现在,这些成果一起开源了:Zeabur Identity、Zeabur Builder、Zeabur Catalog 和管理界面,可以各自独立发展,也能和其他 Kubernetes 工具一起使用。开发用的 skills 也保留在代码仓库里,有兴趣的人可以看看我们怎么查规范、检查界面、复现问题,以及让 Agent 接手工作。已有环境的团队可以选用适合自己的部分;从一台服务器开始的人,也有安装和部署流程可以跟着试。
四年的工单和反馈,让我们知道哪些事情值得重新做好;去掉那层抽象之后,这些事终于做得到了。开源的 Zeabur 还会继续迭代,但你过去熟悉的部署方式、团队已经习惯的操作,都能在新架构里继续使用。如果你以前用过 Zeabur,欢迎回来看看,那些曾经让你卡住的地方,现在是怎么做的。